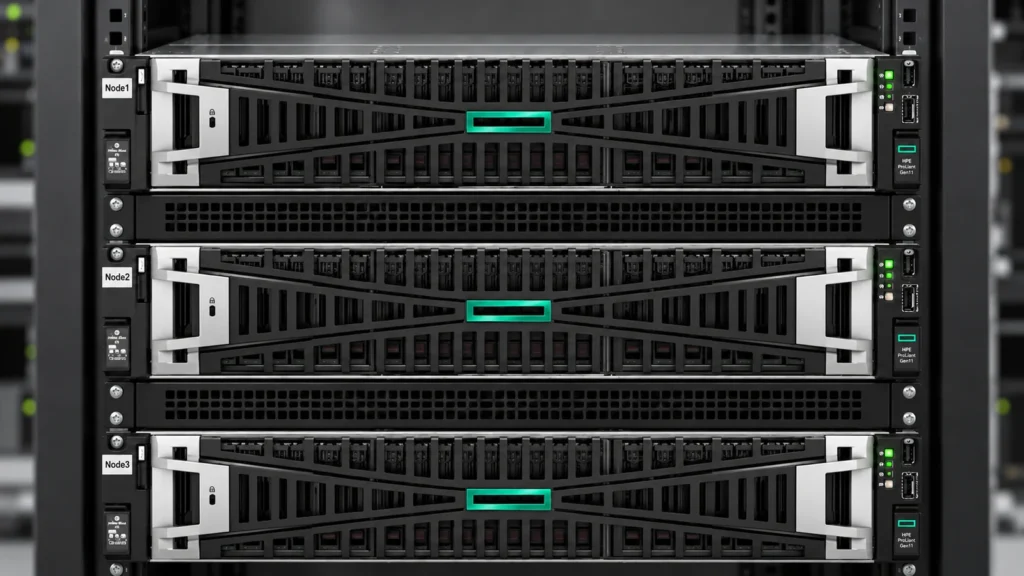
Tři rackové servery HPE samy o sobě netvoří odolný cluster Proxmox. Cíl lze ověřit teprve tehdy, když po výpadku uzlu zbývá dostatek výkonu, paměti, dostupných dat VM, sítě a napájecích cest. Tento příklad ukazuje rozhodnutí potřebná pro sestavu Proxmox VE se třemi HPE ProLiant DL360 Gen11.
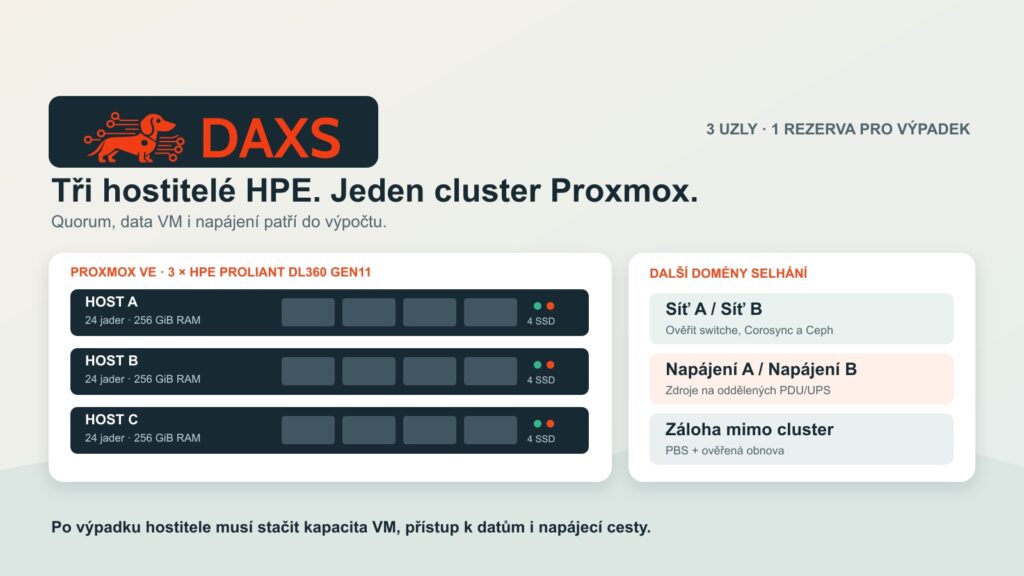
Článek popisuje hypotetický návrhový profil, nikoli hotové objednací číslo HPE. Na uzel se předpokládá procesor s 24 jádry, 256 GiB paměti ECC, zrcadlená spouštěcí média, čtyři podnikové SSD SAS po 3,84 TB pro data VM, dva redundantní zdroje a odpovídající síťové přípojky 25 Gbit. HPE nabízí DL360 Gen11 jako rackový server s různými procesory, DIMM, disky, sítěmi a zdroji. Schválení přesné kombinace procesoru, backplane, režimu HBA/JBOD, SSD, ventilátorů, NIC, kabelů a firmwaru patří do kontroly kusovníku a kompatibility potvrzené partnerem HPE. Disky OSD pro Ceph nesmí být skryté za nevhodným hardwarovým RAIDem.
Stačí rezerva po výpadku hostitele?
Tři uzly poskytují hrubě 72 fyzických jader a 768 GiB RAM. Po výpadku jednoho zbývá 48 jader a 512 GiB. V příkladu rezervujeme na každém zbývajícím hostiteli čtyři jádra a 32 GiB pro Proxmox, Ceph a provozní špičky. Pro VM tedy výpočtem zůstává 40 ekvivalentů jader a 448 GiB RAM. Naměřená špička 28 ekvivalentů jader a 300 GiB RAM pro VM by v tomto modelu ponechala rezervu 12 ekvivalentů jader a 148 GiB. Samotný počet vCPU není měření: CPU steal, NUMA, I/O, obsazení RAM a rozmístění jednotlivých velkých VM je nutné zaznamenat v pilotu. Do přejímky patří i doba opětovného spuštění a priority aplikací.
Pro spolehlivé quorum v režimu HA potřebuje Proxmox alespoň tři hlasy. Při třech rovnocenných uzlech zůstávají po výpadku jednoho dva hlasy, tedy většina. To ještě nezaručuje restart VM: data musí být dostupná, cílový hostitel musí mít prostředky a pravidla HA musí odpovídat. Síť Corosync potřebuje stabilní nízkou latenci a nezávislou druhou cestu. Společný vadný switch nebo sdílená PDU zamýšlenou redundanci hostitelů zruší.
Místní SSD: která data zůstanou po výpadku dostupná?
V tomto příkladu tvoří dvanáct místních datových SSD pool Ceph se třemi kopiemi a hostitelem jako doménou selhání. Hrubá kapacita je 3 × 4 × 3,84 = 46,08 TB . Tři kopie snižují teoretickou využitelnou kapacitu před metadaty a rezervami na 15,36 TB. S limitem stanoveným pouze pro plánování ve výši 70 % dostaneme pracovní hodnotu přibližně 10,75 TB. Nejde o zaručenou kapacitu Ceph: zaplnění OSD, rozložení, obnova, snapshoty a skutečné datové vzory se musí měřit.
Při výpadku jednoho ze tří hostitelů mohou dvě zbývající kopie dál obsluhovat I/O s vhodně nastaveným pravidlem min_size; pool je pak degradovaný. Třetí kopii na třetí hostitelské doméně selhání lze obnovit až po návratu nebo náhradě uzlu. To je hranice návrhu s právě třemi uzly. Replikace Ceph také nenahrazuje samostatnou zálohu. Proxmox Backup Server patří mimo tyto tři hostitele do vlastní domény selhání, s ověřenou obnovou a další externí kopií. Článek DAXS Proxmox Backup Server: ověření, uchovávání a obnova rozvádí test obnovy podrobněji.
Síť a napájení jsou součástí architektury
Pro Ceph jsou důležité propustnost a nízká latence; u nového clusteru plánujeme oddělené, redundantně připojené cesty 25 Gbit jako ověřitelný výchozí předpoklad. Potřebná rychlost vyplývá ze zápisové zátěže, replikačního provozu a cílové doby obnovy, nikoli z počtu portů v katalogu. Corosync má využívat nezávislé fyzické cesty; správa a provoz VM se vhodně oddělují nebo omezují. Přesné přiřazení VLAN, switchů a NIC se dokumentuje plánem portů.
Dva zdroje v serveru pomáhají jen na oddělených napájecích cestách. DAXS by nechal na každém hostiteli připojit zdroj A k PDU/UPS A a zdroj B k PDU/UPS B, ověřit příkon při zátěži a vyzkoušet ztrátu jedné cesty. Správa iLO, náhradní SSD, údržba firmwaru a servisní okna jsou další provozní položky. Tři servery v jednom racku nechrání před výpadkem celé místnosti.
Otevřený výpočet na tři a pět let
Aktuálně potvrzená nabídka HPE za plně vybavený uzel nechť činí h eur, redundantní síť včetně optiky n, samostatný zálohovací server s médii k. Servis HPE a náhradní díly stojí v modelu s eur ročně, elektřina a housing e eur ročně. Tyto nabídkové hodnoty si nevymýšlíme. Zveřejněné ceníky Proxmox uvádějí 550 € ročně za obsazenou patici VE a 2 240 € za server PBS Standard: zde 3 × 550 + 2 240 = 3 890 € ročně. Jednorázově se hypoteticky počítá s 80 hodinami po 90 € (7 200 €) na sestavení, testy a předání; ročně s 50 hodinami po 90 € (4 500 €) na provoz.
| Položka | 3 roky | 5 let |
|---|---|---|
| Uzly, síť, zálohovací hardware | 3h + n + k | 3h + n + k |
| Jednorázové sestavení | 7 200 € | 7 200 € |
| VE/PBS + provoz ročně | 3 × (3 890 + 4 500 + s + e) | 5 × (3 890 + 4 500 + s + e) |
| Celkem | 3h + n + k + 32 370 + 3s + 3e € | 3h + n + k + 49 150 + 5s + 5e € |
Citlivost lze přímo odečíst: navýšení o 1 000 € za uzel zvýší oba horizonty o 3 000 €; navýšení ročního servisu HPE o 1 000 € znamená 3 000, respektive 5 000 €. Potřebuje-li každý hostitel druhý obsazený procesor, při stejné úrovni Proxmox Standard přibude jen za předplatné 1 650 € ročně, plus hardware, RAM a energie. Výpočet nezahrnuje migraci z VMware, druhé zálohovací místo ani růst cen; tyto položky je nutné pro konkrétní rozhodnutí doplnit.
DAXS nejprve prověří špičky a cíle při výpadku, potom schválený kusovník HPE, plán portů a napájení, obnovu Ceph a záloh i úplné nabídky. Plánování takového clusteru pro vlastní prostředí lze zahájit přes Kontakt a domluvit další postup.
Zdroje: HPE ProLiant DL360 Gen11 QuickSpecs · Proxmox VE Administration Guide: cluster, HA a Ceph · Ceph: počet kopií a min_size · Proxmox VE: ceny předplatného · Proxmox Backup Server: ceny.