Ceph, replikace ZFS a externí SAN či NAS mohou pomoci VM Proxmox přežít výpadek hostu. Liší se však aktuálností dat, obnovením provozu i doménou selhání. Pouhé zaškrtnutí „vysoká dostupnost“ často zakrývá skutečný požadavek: kolik minut ztráty dat aplikace snese (RPO) a kdy musí být znovu použitelná (RTO)?
Srovnáváme tři cesty ukládání pro stejný hypotetický cluster se třemi hosty. Jak Ceph obnovuje kopie po výpadku hostu popisuje samostatný článek. Zde rozhodování začíná aplikacemi a jejich ověřitelnými cíli obnovy. Ve všech variantách je navíc třeba oddělená záloha s testem obnovy.
Tři architektury, tři různé cesty při výpadku
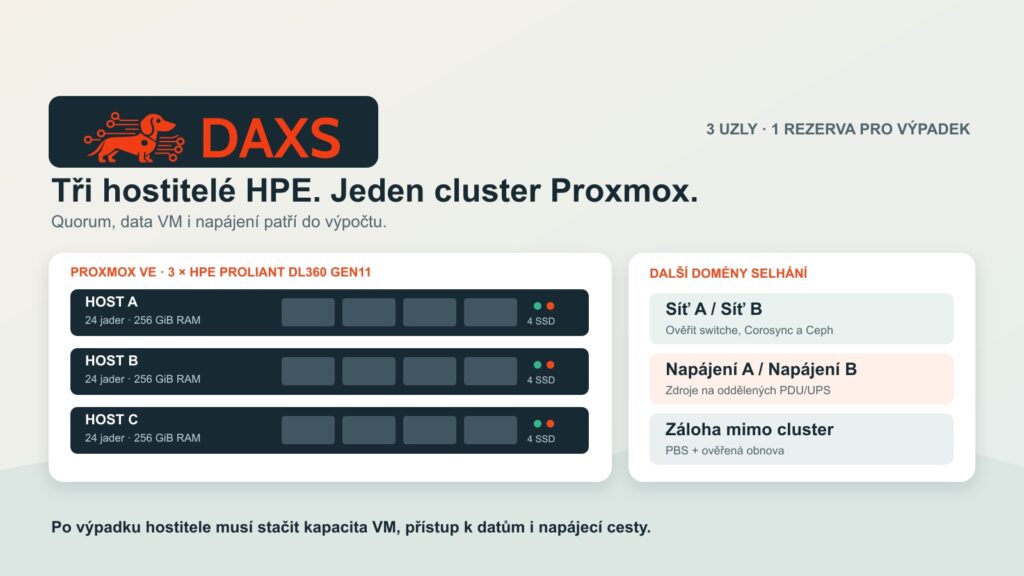
Ceph na lokálních SSD poskytuje disk VM jako distribuované blokové úložiště dostupné v celém clusteru. Replikovaný pool drží kopie na více hostech; quorum, pravidlo poolu, síť a volná kapacita musí odpovídat zvolené doméně selhání hostu. Po výpadku hostu VM může Proxmox HA spustit VM na jiném hostu, pokud je dostupné quorum a zdroje. Probíhající zápis, hostovaná aplikace a její transakce se přesto musí posoudit v testu. Samotná redundance Ceph neslibuje nepřerušenou VM ani garantované nulové RPO pro každou aplikaci.
Lokální ZFS s replikací úložiště Proxmox přenáší svazky VM v intervalech pomocí snapshotů na jiný host. Cíl obsahuje stav poslední úspěšně dokončené replikace. Proxmox dovoluje HA s touto replikací, ale výslovně upozorňuje na možnou ztrátu dat od poslední synchronizace. Nastavený pětiminutový interval proto není obecný slib RPO: počítají se zpoždění, neúspěšné úlohy a stav aplikace. Bez synchronního sdíleného disku musí znovu spuštěná VM zvládnout právě tento starší stav.
Externí sdílené úložiště jako NFS nebo iSCSI zpřístupňuje disky VM více hostům a obvykle dovoluje živou migraci bez kopírování disku. Při výpadku hostu závisí riziko dat na skutečném návrhu úložiště. Nutno ověřit dva řadiče, oddělené datové a napájecí cesty, multipathing u iSCSI či redundantní síťové cesty NFS, podporu a otestovaný failover řadiče; jediný NAS zůstává centrální doménou selhání. Dokumentace Proxmox výslovně varuje, aby zařízení ZFS-over-iSCSI nebylo jediným bodem selhání. „Shared“ v konfiguraci není důkaz redundantního zařízení.
Jaká zátěž snese jaké RPO a RTO?
RPO měří maximální přijatelnou ztrátu dat, RTO maximální přijatelný čas do použitelné aplikace. Následují rozhodovací otázky, nikoli produktová SLA. U každé služby se musí společně testovat databáze, restart VM, DNS, přihlášení uživatelů a závislé systémy.
| Aplikace a cíl | Možná cesta | Rozhodující zkouška |
|---|---|---|
| Transakční databáze ERP; téměř žádná ztráta dat není přijatelná | Ceph nebo prokazatelně redundantní sdílené úložiště; případně navíc aplikační replikace | Latence zápisu, konzistence transakcí, quorum a skutečný restart při poruše hostu/úložiště |
| Interní testovací VM nebo obnovitelná webová služba; minutová ztráta dat přijatelná | Lokální ZFS s replikací může stačit | Stáří posledního úspěšného snapshotu, alarm při zpoždění, start se staršími daty |
| Existující podporovaný SAN/NAS s dostatečnou rezervou | Další využití jako sdílené úložiště může být hospodárné | Společně testovat řadiče, cesty, napájení, firmware, servisní smlouvu a živý failover |
Pro produkční databázi s velmi přísným RPO může být asynchronní replikace ZFS nevhodná, i když HA restart funguje. Obnovitelná testovací služba naopak automaticky neodůvodňuje Ceph. Tři hosty Proxmox neudělají z jediného úložného serveru redundantní systém. Technická volba vychází z přijatelné ztráty dat a naměřeného přerušení, ne jen z názvu produktu.
Tříletý a pětiletý výpočet bez smyšlených tržních cen
Hypotetické srovnání předpokládá tři stejné jednosocketové hosty s pořizovací cenou h za host a oddělený zálohovací server s médii za cenu b . Podle aktuálního ceníku výrobce stojí Proxmox VE Standard 550 € za osazený CPU socket a rok, Proxmox Backup Server Standard 2 240 € za server a rok. Společná podpora tedy činí 3 × 550 + 2 240 = 3 890 € ročně. Model používá 90 € za hodinu práce bez daně. Bez ověření nepředpokládá stejné IOPS ani využitelnou kapacitu: nabídky je třeba nejprve normalizovat na stejnou zátěž.
d značí další datová SSD Ceph na host, z lokální výbavu SSD ZFS na host, a redundantně navržené externí zařízení, nc, nz a ns potřebné síťové či fabric investice pro jednotlivé varianty. ec, ez a es jsou roční dodatečné náklady energie/housingu; s je roční servisní smlouva výrobce externího zařízení. Všechna písmena jsou nabídkové částky v eurech bez daně, ne tvrzené tržní ceny.
| Cesta | Instalace / roční provoz | 3 roky | 5 let |
|---|---|---|---|
| Ceph | 80 h / 50 h | 3h + b + 3d + nc + 32 370 + 3ec € | 3h + b + 3d + nc + 49 150 + 5ec € |
| Replikace ZFS | 50 h / 30 h | 3h + b + 3z + nz + 24 270 + 3ez € | 3h + b + 3z + nz + 37 450 + 5ez € |
| Externí úložiště | 60 h / 35 h | 3h + b + a + ns + 26 520 + 3s + 3es € | 3h + b + a + ns + 40 600 + 5s + 5es € |
Hodiny práce jsou pouze modelové předpoklady, nikoli paušál DAXS. Příklad: o 1 000 € vyšší roční servis zařízení zvýší externí variantu za tři roky o 3 000 € a za pět let o 5 000 €. Existující zařízení může snížit a v daném období, ale zbývající životnost, podpora, náhradní díly a rozšíření patří do s nebo samostatné investiční položky. Ceny hardwaru, využití prostoru, výkonový profil, síť, daň a místo provozu musí doložit nabídky. Nejnižší výsledek vzorce bez stejné kapacity, IOPS, RPO a RTO není rozhodnutím k nákupu.
Převzetí: skutečně přehrát výpadek každé domény
DAXS by pro každou vhodnou architekturu požadoval čtyři důkazy: (1) čas posledního konzistentního aplikačního stavu, (2) měření výpadku hostu a restartu VM se zátěží, (3) cílený výpadek kritické úložné nebo síťové cesty a (4) obnovu VM a jednotlivých aplikačních dat z oddělené zálohy. U ZFS zahrnout neúspěšnou či opožděnou replikační úlohu; u Ceph degradovaný pool a obnovu; u SAN/NAS přepnutí řadiče a cesty. Až měření rozhodnou, zda se RPO a RTO dosahuje.
Kopie Ceph, replikační snapshoty a zrcadlení pole dále přenášejí i smazání a chybná data. Nenahrazují verzování, externí kopii ani test obnovy. Článek DAXS Proxmox Backup Server: ověření, uchovávání a obnova podrobněji řeší převzetí záloh. Kdo má seznam aplikací a cíle RPO/RTO, může přes Kontakt nechat s DAXS změřit tři cesty na skutečné zátěži a stávajících smlouvách.
Zdroje: Proxmox VE Administration Guide: úložiště, replikace úložiště a HA · Proxmox VE: aktuální ceny podpory · Proxmox Backup Server: aktuální ceny podpory.