
Když lokalita ztratí spojení, nemají desítky následných hlášení představovat stejný výpadek jako mnoho samostatných poruch. Zabbix dokáže propojit metriky, podmínky a oznámení. Praktický přínos vychází z otázky, jaké rozhodnutí má hlášení vyvolat.
Od pracovního procesu k měření
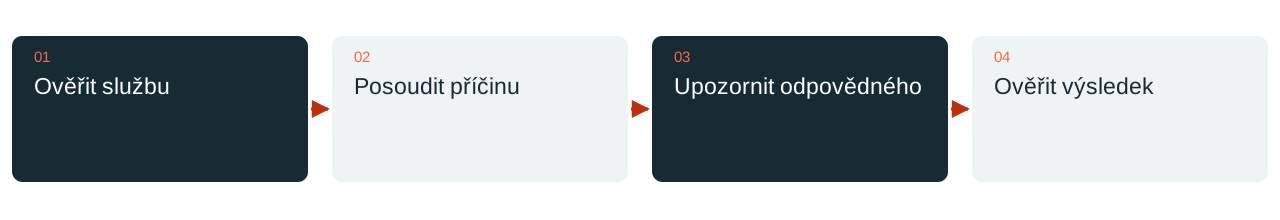
Výchozím bodem je konkrétní služba: dostupná podniková aplikace, včas dokončená záloha nebo dostatek využitelného úložiště. Pro ni se vyberou vhodné technické body měření. Odpovídající server ještě nedokazuje, že se uživatelé mohou přihlásit do aplikace a dostávají správné výsledky.
Každá důležitá kontrola dostane odpovědnou osobu a očekávanou reakci. U kapacity může stačit včasné plánování; u nefunkční produkční služby může být nutný přímý kontakt. Důležitost vyplývá z dopadu na provoz, nikoli z obzvlášť výrazné barvy.
Závislosti omezují zbytečná hlášení
Zabbix popisuje závislosti triggerů jako prostředek k vhodnému zpracování závislých událostí při nadřazené poruše. Mohou pomoci odlišit výpadek centrálního spojení od jeho následků. Závislost však musí odpovídat skutečné síti a logice měření.
Výpadek lokality nesmí skrýt jinou nezávislou poruchu. Vztahy se proto ověřují na skutečných chybových scénářích. Také příliš dlouhé zpoždění nebo příliš benevolentní mez může skrýt reálný problém. Klidný seznam hlášení není dostatečným důkazem dobrého monitoringu.
Plánovat okna údržby a eskalaci
Plánovaná údržba se promítne do monitoringu. Zabbix mimo jiné rozlišuje zpracování sběru dat a událostí během údržby. Zvolené nastavení se vědomě ověří namísto plošného vypnutí veškerého sledování. Po skončení údržby musí být znovu rozpoznatelný běžný stav.
Cesta oznámení zohledňuje pracovní dobu, sjednané způsoby reakce a zastupování. Nevyplývá z ní obecný příslib nepřetržité dostupnosti. Eskalace je užitečná jen tehdy, pokud je dotčená osoba dosažitelná a ví, jaké informace dostane pro posouzení situace.
Testovat alarmování jako funkci
Řízený test ověřuje měření, spuštění, doručení, převzetí a vyřešení. Patří k němu i oznámení návratu do normálu. Pro test je vhodnější omezený a předem domluvený scénář než neplánovaný zásah do produkční služby.
DAXS se Zabbixem vytváří monitoring vhodný pro dané prostředí a propojuje ho s dokumentací a provozem. Rozumným začátkem je několik důležitých služeb s plně otestovanými postupy reakce. Další body měření následují, až je jasné, jaký dodatečný užitek přinášejí.
IT podpora a provoz · Infrastruktura · Projednat monitoring
Zdroje: Zabbix: závislosti triggerů (externí odkaz) · Zabbix: okna údržby (externí odkaz)


