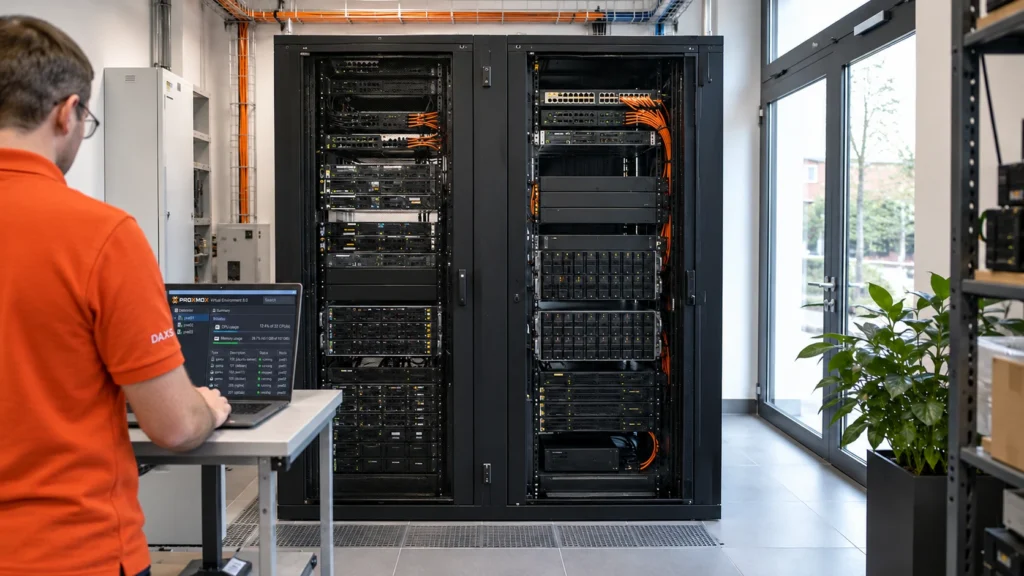
Na stávajícím hostiteli Proxmox zbývá kapacita pro službu AI. Stačí přidat grafickou kartu a vytvořit virtuální stroj? Může to být vhodné řešení, pokud se společně naplánují přiřazení GPU, zdroje hostitele a údržba.
Při passthrough patří fyzická GPU jedné VM
PCIe passthrough předává virtuálnímu stroji kontrolu nad fyzickým zařízením. AI VM používá GPU prostřednictvím vlastního ovladače v hostovaném systému. Hostitel ani ostatní VM nemohou během tohoto přiřazení současně používat stejnou kartu pro vlastní výpočty.
Uvnitř AI VM může sdílená modelová služba zpracovávat více požadavků. To je něco jiného než rozdělení karty mezi několik VM. Vhodnost samostatného řešení vGPU závisí také na GPU, hypervizoru, ovladačích, podporovaných konfiguracích a licencích.
Výhodou VM je jasně vymezené systémové prostředí: operační systém, modelový server a potřebná data lze spravovat společně. GPU zůstává fyzickým zařízením s vlastními předpoklady.
Před instalací ověřit celý hardwarový řetězec
Dokumentace Proxmoxu vyžaduje podporu IOMMU včetně přemapování přerušení. CPU, základní deska, firmware a podpora Linuxu musí být kompatibilní. Samotné označení VT-d nebo AMD-Vi tuto kontrolu nenahrazuje.
Důležitá je také skupina IOMMU zvoleného slotu. GPU a její přidružené funkce mají být vhodně odděleny od ostatních potřebných zařízení. Dokumentace Linux VFIO vysvětluje, proč skupina tvoří hranici přiřazení a izolace. Jiný slot může znamenat jiné seskupení.
Kontroluje se rovněž prostor, elektrické připojení PCIe, napájení a chlazení. V hostovaném systému musí být vhodný ovladač GPU a podpora modelové služby. Pro GPU passthrough Proxmox obvykle doporučuje q35 s OVMF/UEFI a PCIe; vyhovovat musí i firmware karty. Konkrétní nastavení závisí na použitém hardwaru.

Dostupná kapacita je společný rozpočet
Příkladem plánování je stávající virtualizační hostitel s firemními aplikacemi a další AI VM. Čas CPU, operační paměť, úložiště a síť zůstávají sdílenými zdroji. Neomezený import dokumentů nebo spuštění modelu nemá nečekaně zpomalit ostatní aplikace.
VM proto dostane jasně popsané prostředky a limity zátěže. Grafická paměť, délka kontextu a souběžné požadavky na model se testují společně. Více operační paměti přiřazené VM nezvětší fyzickou VRAM karty. Přesun části výpočtů na CPU může změnit chování a vyžaduje samostatné měření.
Pro férové porovnání se zaznamená verze modelu, vstupy, kontext a souběžnost. Hodnotí se kvalita, první odpověď, další výstup, čekání a vliv na ostatní VM. Paušální procento režie virtualizace by bez konkrétního testu příliš nepomohlo.
VM, nebo vyhrazený počítač: co se mění v provozu?
| Otázka | AI VM s GPU passthrough | Vyhrazený AI server |
|---|---|---|
| Zdroje | GPU pevně přiřazená; ostatní zdroje hostitele sladit se stávajícími VM. | Výpočetní a paměťové zdroje má k dispozici vlastní systém. |
| Údržba | Společně plánovat ovladače hostovaného systému, provoz modelů a aktualizace Proxmoxu/hostitele. | Operační systém a provoz modelů ve vlastní oblasti údržby. |
| Změna hostitele | Přímo předaná PCI zařízení brání běžné živé migraci. Při přesunu zastavené VM ověřit vhodný cílový hardware a přiřazení. | Přesun nebo náhrada pomocí připravené obnovy provozu na jiném hardwaru. |
| Zálohování | Společně posoudit disky VM, aplikační konzistenci, konfiguraci a přiřazení zařízení. | Samostatně zajistit systémová/aplikační data a obnovu. |
| Náročnost | Lze využít stávající infrastrukturu; započítat integraci a další závislosti na hostiteli. | Naplánovat vlastní hardware a zdroje lokality; údržba je přitom jasněji oddělená. |
Stávající cluster automaticky neumožní přesouvat AI VM vázanou na fyzický hardware bez přerušení. Restart na jiném uzlu potřebuje kompatibilní GPU zdroje, platné přiřazení a skutečně otestovaný postup. Požadavky na službu určují, zda tato příprava stačí, nebo zda je vhodný další uzel služby.
Obnova má prokázat více než spuštění VM
Kopie virtuálního disku neobsahuje běžící stav fyzické grafické karty. Při obnově se proto kontrolují i verze modelů, konfigurace, práva k datům a opětovné přiřazení zařízení. Snapshot na stejném hostiteli nenahrazuje oddělenou zálohu.
Přejímka zahrnuje běžný restart VM, restart hostitele, změnu ovladače/jádra v plánovaném okně údržby a plánovanou obnovu. Poté se ověří skutečný požadavek na model a ostatní aplikace. Ukáže se tak, zda je zařízení po restartu znovu řádně dostupné.
Pro čistě výpočetní akcelerátor není nutný monitor připojený ke GPU. Konzole Proxmoxu jednoduše nezobrazuje obraz přímo předané GPU. Služba AI se používá přes určené rozhraní nebo API.
Podložit rozhodnutí omezeným pilotem
DAXS nejprve vyjasní úlohu, stávajícího hostitele, rozsah používání a přijatelné přerušení. Omezený pilot následně ověří přiřazení zařízení, věcnou kvalitu a dopady na provoz. Podle výsledku může být vhodná VM, vlastní počítač nebo externí služba.
Naše posouzení Proxmoxu pro firmy vysvětluje obecnou volbu platformy. Naše stránka o lokální infrastruktuře LLM a pilot zátěžového testu rozvádějí dimenzování. Článek Ollama a Open WebUI doplňuje architekturu společné služby.
Probrat provozní model AI a stávající infrastrukturu.
Zdroje: Proxmox: PCIe passthrough (externí odkaz) · Proxmox: migrace virtuálních strojů (externí odkaz) · Linux: VFIO a skupiny IOMMU (externí odkaz) · NVIDIA: matice podpory vGPU (externí odkaz) · Ollama: hardwarová podpora (externí odkaz).